
Proyecto ML · PyCon ES Barcelona 2026
¿Qué hueso es?
Clasificación zooarqueológica jerárquica con datos sintéticos y transfer learning
Abstract
Identificar un hueso a partir de una foto es trabajo de experto, y hay pocas fotos etiquetadas con las que entrenar un clasificador. Aquí se construye el dataset con renders 3D sintéticos (Blender + BlenderProc) y se clasifica en cascada: filtro CLIP → confirmación CNN → modelo híbrido (geometría + embedding) → expertos por grupo de hueso. La pregunta de fondo no es la accuracy en sí, sino si lo aprendido con sintético generaliza a foto real, y qué cuesta cada punto de mejora.
1. Motivación: cuando los huesos cuentan otra historia
En el palacio romano de Fishbourne (Sussex, UK), unos huesos de ave excavados en los 60 se identificaron en 1971 como avutarda (Otis tarda). Esa identificación se citó durante décadas en estudios sobre Britania romana y dieta medieval. En 2009 alguien volvió a mirar los mismos huesos: eran grulla común (Grus grus). Cuarenta años de literatura construida sobre un error de ojo.
No es un caso raro — es lo normal cuando la identificación depende solo del ojo de un especialista, sin segunda opinión. De ahí la pregunta: ¿puede un clasificador automático servir de segunda opinión barata y reproducible, cuando apenas hay datos reales para entrenarlo?
2. Datos
122 especímenes 3D de Sketchfab, MorphoSource y Smithsonian, renderizados en Blender con BlenderProc (física, luz HDRI, escena de mesa de laboratorio). La máscara de segmentación sale gratis de la geometría 3D, más fiel que estimarla a ojo sobre una foto. El dataset mezcla esa síntesis masiva con una porción pequeña, a propósito, de foto real curada.
| Grupo | Real | Sintético | Total |
|---|---|---|---|
| hueso_largo | 72 | 628 | 700 |
| cráneo | 110 | 437 | 547 |
| vértebra | 38 | 372 | 410 |
| hueso_pequeño | 30 | 284 | 314 |
| mandíbula_maxilar | 24 | 218 | 242 |
| costilla | 37 | 195 | 232 |
| sacro | 21 | 200 | 221 |
| hueso_plano | 16 | 182 | 198 |
| pelvis | 19 | 55 | 74 |
| Total | 367 | 2571 | 2938 |
Tabla 1 — Distribución real/sintético por grupo osteológico (dataset combined_lab.csv). 12.5% del dataset es foto real.
Split train/val 87/13, pero por espécimen, no por imagen: todas las vistas de un mismo hueso quedan en el mismo lado. Si no, el modelo memoriza el espécimen concreto en vez de aprender el grupo.
3. Por qué segmentar: el fondo como atajo
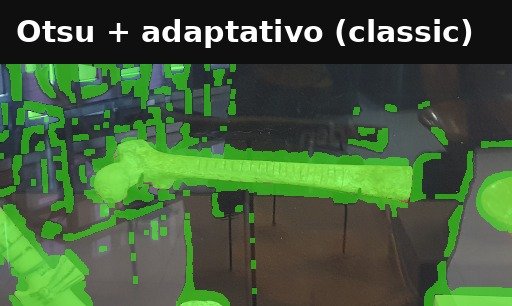
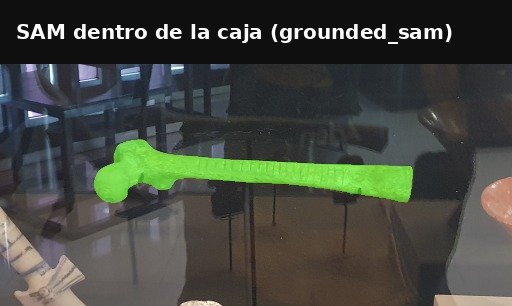
La primera versión entrenaba la CNN sobre la imagen completa, fondo incluido. Con fondo de estudio homogéneo: 0% de accuracy en foto real. El modelo no aprendía forma de hueso, aprendía textura y color de fondo — una señal que no existe en una foto tomada con el móvil sobre cualquier superficie.
| Backend de segmentación | Accuracy | Balanced accuracy |
|---|---|---|
| Otsu (classic) | 21.7% | 25.3% |
| FastSAM | 31.4% | 21.2% |
| Grounded-SAM | 39.1% | 29.3% |
Tabla 2 — Accuracy del clasificador geométrico según backend de segmentación usado en preprocesado. Mismo modelo downstream (RandomForest, 51 features OpenCV), solo cambia el aislamiento del objeto.
4. Dominio sintético → real: cerrando la brecha
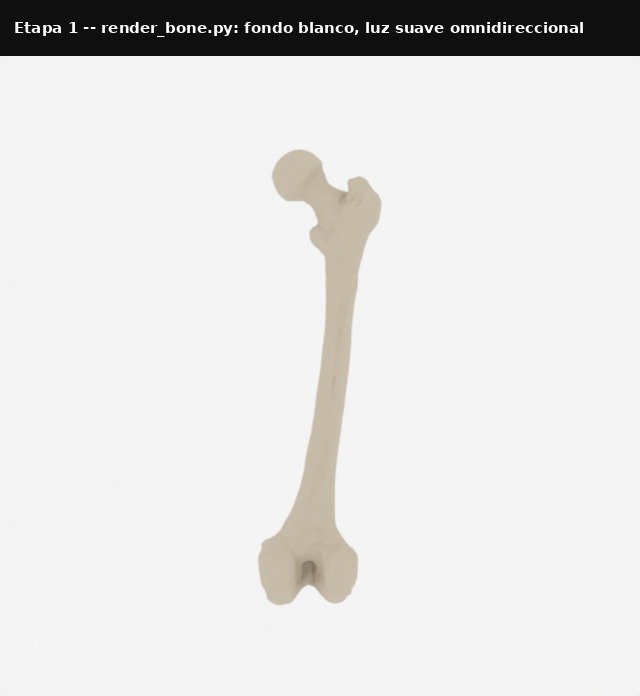
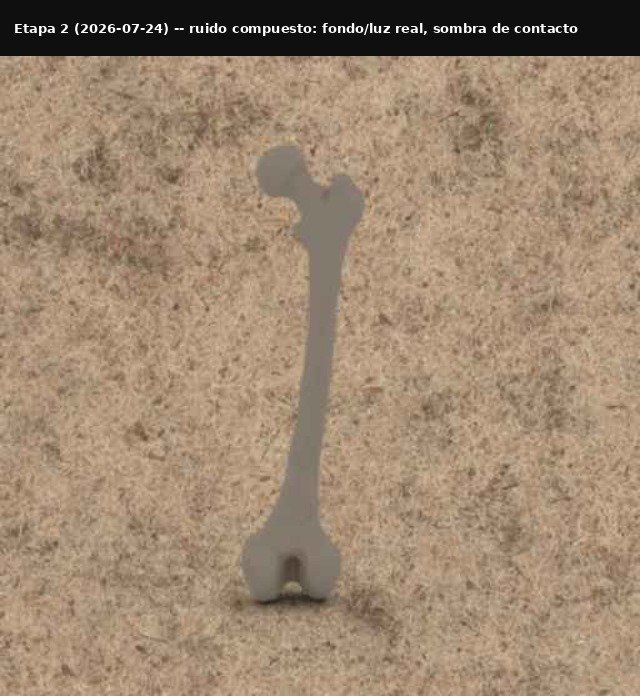
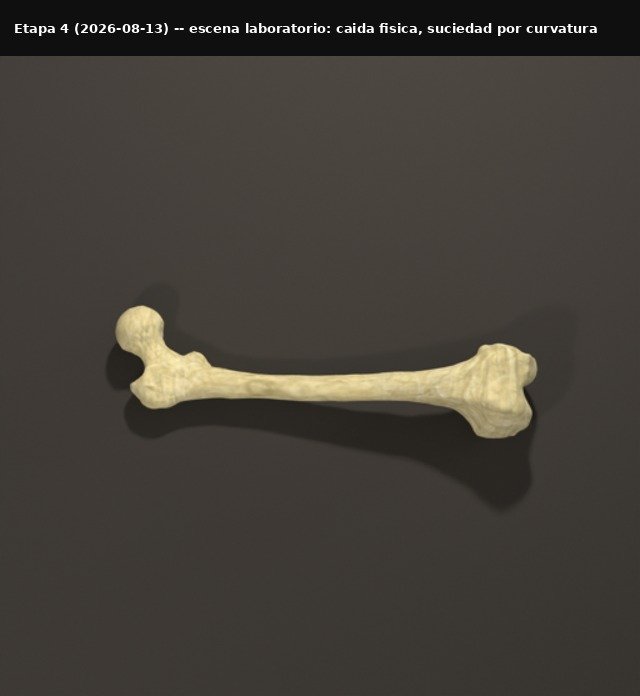
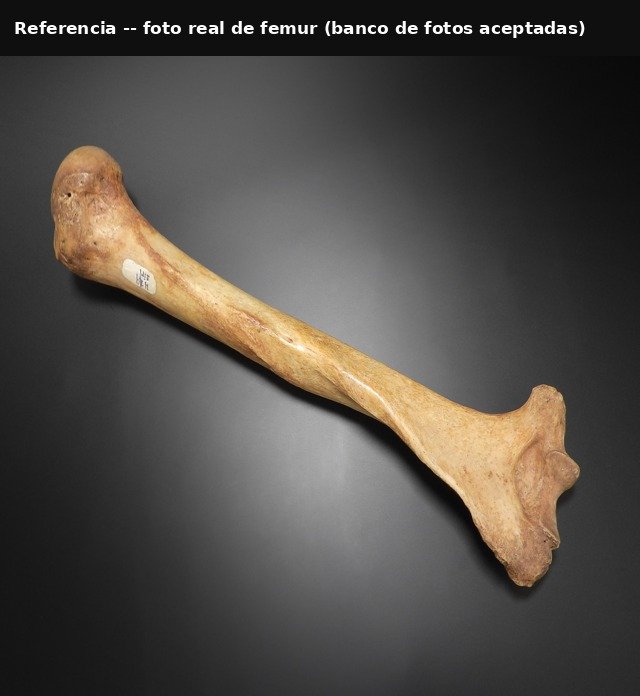
El render limpio no se parece a una foto real: falta ruido de cámara, suciedad, luz irregular, textura ósea real. Se fue añadiendo ruido por capas (fondo, luces, manchas, mineralización) hasta acercarse, y al final se metieron fotos reales directamente en el entrenamiento.
| Experimento | Geométrico | CNN | Híbrido |
|---|---|---|---|
| Grounded-SAM (base) | 0.5185 | — | 0.6296 |
| + Ruido clásico + BlenderProc combinado | 0.4815 | 0.5741 | 0.6852 |
| + 12 fotos reales en entrenamiento | 0.5926 | 0.6667 | 0.7593 |
Tabla 3 — Accuracy sobre banco real fijo, progresión de realismo de render. El modelo geométrico puro empeora con más ruido (sensible a artefactos); el híbrido y la CNN mejoran de forma monótona. 12 fotos reales más aportan más que todo el esfuerzo de renderizado fotorrealista.
UMAP embeddings DINOv2-small — sintético vs real
cargando…
hybrid_lab (capa de 128-d, justo antes de clasificar), extraídos en vivo para esta página sobre una muestra equilibrada por grupo. Arrastra, haz zoom y filtra por la leyenda: los clusters se solapan por grupo independientemente del dominio — evidencia de que el modelo aprende forma, no textura de render.| Modelo | Accuracy | Balanced acc. | Macro F1 | Top-3 |
|---|---|---|---|---|
| Solo real (entrenamiento) | 0.6667 | 0.6951 | 0.63 | 0.9815 |
| Solo sintético (entrenamiento) | 0.6667 | 0.6951 | 0.61 | 0.8704 |
| Real + sintético combinados | 0.8421 | 0.8664 | 0.78 | 0.9815 |
| DINOv2-small (modelo final) | 0.8958 | 0.8757 | 0.86 | 0.9583 |
Tabla 4 — Generalización sim-to-real evaluada sobre banco real fijo. Mezclar dominios bate a cualquiera de los dos por separado.
5. Selección de arquitectura: ViT vs CNN
Screening a 1 semilla sobre 6 backbones sugería que DINOv2-reg4 ganaba con margen. Al confirmar con 3 semillas obligatorias (protocolo fijo para cualquier comparación de este proyecto), reg4 no sostiene la ventaja y es DINOv2-small quien gana de forma consistente. El experimento de 1 semilla habría llevado a la decisión equivocada.
Fig. 2 — DINOv2-reg4 parecía ganar a 1 semilla (0.875) pero no aguanta a 3 semillas (media 0.810, por debajo de DINOv2-small 0.820). Sin este protocolo se habría promovido el modelo equivocado a producción.
6. Arquitectura del sistema: cascada jerárquica
El pipeline de producción no es un único clasificador sino una cascada de filtros y expertos, cada uno entrenado solo en su subproblema:
- CLIP zero-shot (sin entrenar, coste casi cero) — ¿es esto un hueso?, sugerencia de grupo por similitud texto-imagen.
- ResNet18 entrenado — confirmación del filtro anterior.
- Modelo híbrido (features geométricas OpenCV + embedding DINOv2) — decide grupo morfológico entre 9 clases.
- Expertos de etapa 2, uno por grupo — hueso concreto (fémur/húmero/astrágalo/vértebra...) y taxón (humano/carnívoro/ungulado/roedor/otro primate).
7. Features geométricas (OpenCV)
51 features por imagen, extraídas del contorno segmentado. No sustituyen al embedding del backbone — lo complementan: una elipse o un perfil de anchura capturan invarianzas que un ViT entrenado en ImageNet no tiene por qué haber aprendido para huesos.
| Categoría | Métrica | Qué mide |
|---|---|---|
| Caja y área | aspect_ratio | ancho/alto del bbox rotado |
| Forma global | elongation | PCA, 0=compacto 1=alargado |
solidity | área contorno / área hull | |
circularity | 4π·área/perímetro², 1=círculo | |
| Momentos de Hu | hu1...hu7 | invariantes de forma, log-escala |
| Perfil de anchura | width_profile (20) | ancho en 20 cortes del eje |
| Curvatura del eje | tortuosity | long. arco / distancia recta |
turning_consistency | gira siempre al mismo lado | |
| Ajuste canónico | circle_fit_residual | qué tan bien ajusta a un arco |
line_fit_residual | qué tan bien ajusta a una recta | |
n_holes | contornos internos cerrados | |
n_deep_grooves | defectos de convexidad > 2% |
Distribución de elongation por grupo
cargando…
elongation por grupo (datos actuales, — filas). Caja = cuartiles, línea = mediana, puntos = sintético/real con jitter. hueso_largo y costilla se separan con claridad de pelvis/vértebra solo con esta feature.8. Resultados y análisis de errores
Segmentar no solo sube accuracy global: cambia qué confunde el modelo. Recalculado en vivo para
esta página: mismo RandomForest, mismas 216 imágenes del banco limpio (24 por grupo, nunca
vistas en entrenamiento), una vez con segmentación Otsu clásica y otra con Grounded-SAM — pasa el ratón
por cualquier celda de las dos:
cargando…
cargando…
Los errores que quedan tras segmentar son razonables incluso para un experto humano: una costilla fragmentada confundida con hueso_pequeño, una pelvis parcial confundida con hueso_plano. Son errores de forma ambigua, no de atajo aprendido.
9. Limitaciones
- hueso_plano se mantiene débil (recall 0.25–0.50 según semilla) con solo 4 fotos reales de examen para ese grupo. Más realismo de render no mueve la aguja aquí — el cuello de botella es volumen de foto real, no fidelidad sintética.
- Banco de evaluación pequeño: 77–198 fotos reales según el experimento, con grupos de n=4 a n=14. A ese tamaño, diferencias de 2-3 puntos de accuracy cruda no distinguen señal de ruido — el criterio de promoción de modelo usa balanced accuracy + comparación pareada (McNemar) + 3 semillas, nunca "subió el número" sin más.
- Más imágenes no es más diversidad: multiplicar vistas de un mismo espécimen no sustituye disponer de especímenes distintos. El split por
specimenexiste precisamente para no premiar esa falsa diversidad. - Accuracy global puede ocultar fallos locales: un modelo con 0.87 de balanced accuracy puede seguir fallando sistemáticamente en una o dos clases minoritarias — por eso toda tabla de este documento reporta por clase, no solo agregado.
10. Reproducibilidad
Cada experimento (semilla, dataset, arquitectura) queda trazado en MLflow; los datos y modelos versionados con DVC; el código en git. Promover un modelo a "por defecto" exige repetirlo con 3+ semillas y métricas que no se dejen engañar por desbalance de clases.
specimen::specimen Conclusiones
- Los datos reales marcan la diferencia. Incluso unas pocas fotografías reducen la brecha sim-to-real más que cualquier mejora de fidelidad de render.
- Más imágenes no significan más diversidad. Multiplicar vistas de un hueso no sustituye disponer de especímenes distintos.
- Sin métricas adecuadas, mejorar puede ser empeorar. La accuracy cruda por sí sola oculta problemas de clasificación en clases minoritarias.
- Un buen modelo necesita buenos datos. La segmentación, la diversidad y el preprocesado condicionan el resultado final más que la elección de arquitectura.
- El éxito global no elimina los errores locales. Una buena balanced accuracy puede convivir con clases todavía difíciles de identificar.
Líneas futuras
- Ampliar foto real en grupos débiles (prioridad: hueso_plano). Cualquier especie cuenta igual — lo que falta es volumen, no diversidad taxonómica.
- Banco de evaluación más grande y balanceado (de ~200 a 400+ fotos reales), mismo protocolo estadístico.
- Biometría 3D (landmarks), TPS morphing y trayectoria ontogénica para análisis morfométrico más allá de la clasificación.
- Documentación 3D automatizada (fotogrametría + turntable) para generar nuevos especímenes de referencia sin depender de repositorios externos.